

Alarmierung in der Produktion bedeutet, dass durch MES generierte Alarme genutzt werden, um Maschinenstatusänderungen, Ausfallzeiten und Qualitätsabweichungen zu kennzeichnen und diese anschließend automatisch an die richtige Person zu eskalieren. Das empfohlene Muster sind quellmodellierte Alarme mit klaren Schweregraden, zeitgesteuerter Eskalation und einem vollständigen Audit-Trail, ausgerichtet an Standards wie IEC 62682 und ISA-18.2. Plattformen wie Mestric™ integrieren dies direkt in den Fertigungsablauf.
Kurzfassung:
- Die effektivsten Alarmsysteme klassifizieren Meldungen direkt an der Quelle unter Verwendung von OPC-UA-Standards, um eine präzise, zuverlässige und MES-kompatible Stillstandszeitzuordnung sicherzustellen.
- Die regelmäßige Überprüfung von Alarmierungs-Schweregraden und Schwellenwerten ist unerlässlich, um Fehlklassifizierungen, Alarmfluten und den Verlust des Vertrauens in das System zu verhindern.
- Die Weiterleitung von Alarmen basierend auf Skill-Gruppen und die Implementierung einer hierarchischen Eskalation mit definierten Timern verbessert die Reaktionsfähigkeit und liefert wertvolle Daten für die Planung.
- Die Bedienerschulung muss sich auf das Verständnis von Schweregraden, die ordnungsgemäße Quittierung und die systematische Bearbeitung konzentrieren, um die Reaktionszeiten zu verkürzen und das Vertrauen zu stärken.
- Der Einsatz von KI für prädiktive Analysen und Alarmgruppierung verbessert die frühzeitige Erkennung von Problemen und reduziert die Alarmüberlastung, ergänzt jedoch einen gut geführten Alarmierungsrahmen, anstatt ihn zu ersetzen.
Ein MES-Alarmsystem verdient seinen Platz in der Fertigung nur dann, wenn es fünf Dinge gut macht. Wenn Sie diese falsch machen, erhalten Sie am Ende einen Alarm-Feed, dem niemand vertraut.
Alarmbenachrichtigungsplattformen, die SCADA-, MES- und PLC-Warnungen an Bediener weiterleiten in unter zwei Sekunden Mit Multikanal-Zustellung und Audit-Trails zeigen sie, wie weit sich die Technologie von einfachen Signalhorn- und Lichtsystemen entfernt hat. Geschwindigkeit allein ist jedoch nicht das Ziel. Eine vertrauenswürdige Klassifizierung ist ebenso wichtig wie eine schnelle Zustellung.
Die Priorisierung ist der Punkt, an dem die meisten Alarmsysteme scheitern oder erfolgreich sind. Sowohl ISA-18.2 als auch IEC 62682 betrachten das Alarmmanagement als Lebenszyklus und nicht als einmalige Konfigurationsaufgabe, und Der praktische Leitfaden der IChemE empfiehlt, Alarmsätze regelmäßig zu überprüfen, anstatt darauf zu vertrauen, dass die ursprüngliche Einrichtung bei Produktionsänderungen exakt bleibt.
Eine brauchbare Start-Taxonomie sieht so aus:
| Tier | Bedeutung | Typische Antwort |
|---|---|---|
| P1 | Kritisch: Stoppbedingung oder Sicherheitsrisiko | Sofort, eskaliert innerhalb von Minuten |
| P2 | Dringend: Qualität oder Durchsatz gefährdet | Schnelle Reaktion, kurzes Eskalationsfenster |
| P3 | Warnung: Es entwickelt sich zu einem Problem | Innerhalb der Schicht überprüft |
| P4 | Zur Information: Aktuell ist kein Handeln erforderlich | Für Trendanalysen protokolliert |
Jeder Schwellenwert benötigt eine Totzone oder Verweilzeit, bevor er auslöst, andernfalls überschwemmt ein Parameter, der nahe an einer Grenze schwankt, das Protokoll mit doppelten Alarmen. Führen Sie eine Testphase durch, in der Vorgesetzte jede Klassifizierung überprüfen, entscheiden Sie dann, wer danach Schwellenwerte anpassen darf, und protokollieren Sie jede Änderung. Ohne diese Governance-Ebene driftet das Tuning innerhalb von Monaten wieder zum Rätselraten ab.
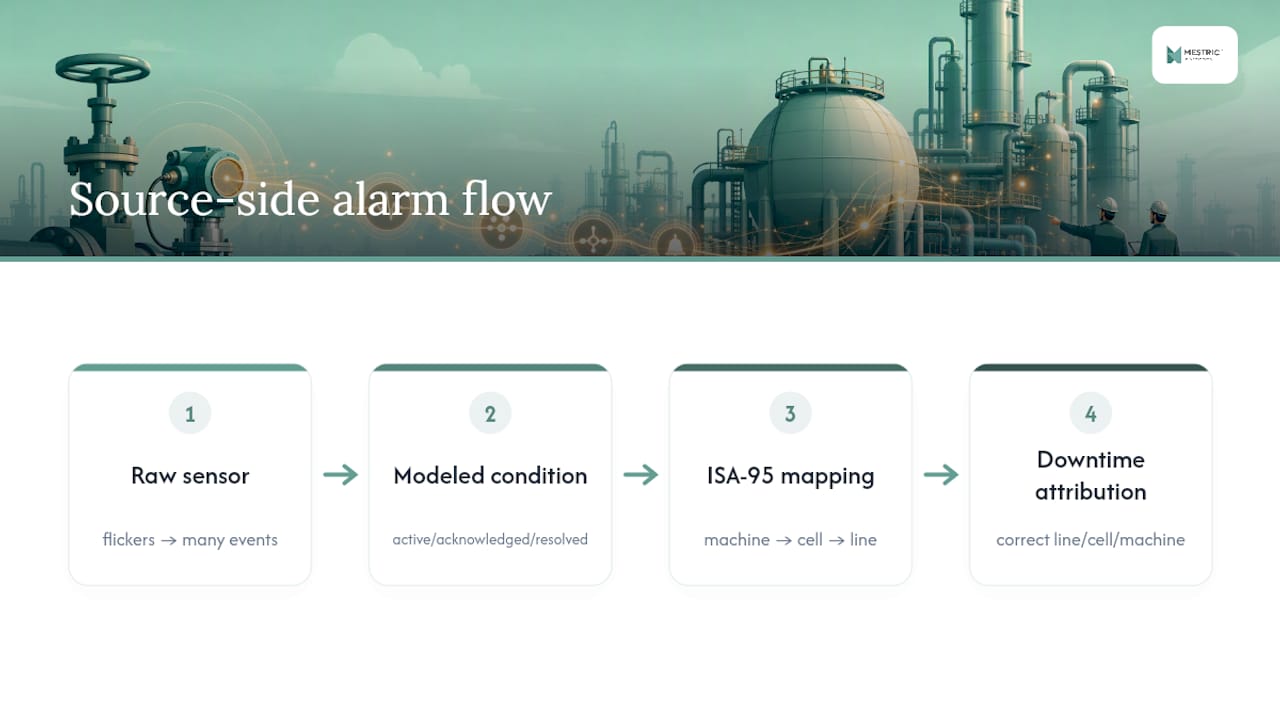
Alarme sollten so nah wie möglich am Equipment und unter Verwendung der OPC UA Alarms & Conditions-Spezifikation klassifiziert werden, anstatt sie dem MES zur Interpretation roher Signale nachgelagert zu überlassen. Die Bedingungstyp und Alarmbedingungstyp Objekte enthalten Lebenszyklusfelder wie Bestätigt und Beibehalten, die jedem nachgeschalteten System ohne Rätselraten mitteilen, ob ein Alarm aktiv, quittiert oder behoben ist.
Das Abonnieren von Roh-Tag-Änderungen anstelle von sauber modellierten Zuständen ist eine häufige Abkürzung, und sie ist der Grund, warum so viele MES-Ausfallberichte unruhig oder schlicht falsch wirken. Ein flackernder Sensor erzeugt Dutzende bedeutungsloser Ereignisse; ein sauber modellierter Zustand erzeugt eines. Das Verknüpfen jedes Quellknoten zu einer ISA-95-Anlagenhierarchie bedeutet, dass Ausfallzeiten automatisch der korrekten Linie, Zelle oder Maschine zugeordnet werden, was enorm wichtig ist, sobald man beginnt, eine Pareto-Analyse der Stillstände durchzuführen. Unterdrückungs- und Totzonenlogik gehören ebenfalls auf diese Quellenebene. Eine Klassifizierung, die am dichtesten an der Anlage erfolgt, bleibt zuverlässig und MES-bereit, anstatt etwas zu sein, das das MES anzweifeln muss.
Routing ist der Teil, den Teams am häufigsten informell belassen, was genau der Grund dafür ist, dass Alarme in der Nachtschicht übersehen werden. Erstellen Sie eine Routing-Tabelle, bevor Sie irgendetwas anderes bauen.
Eine hierarchische, zeitgesteuerte Eskalationsstruktur mit definierten Lösungs-Teams verbessert die Reaktionsfähigkeit in variantenreichen, kleinvolumigen Fertigungsbetrieben und schafft eine Lernschleife für die Zukunftsplanung, weil jedes Eskalationsereignis zu Daten darüber wird, wo sich wiederkehrende Lücken in Ihrer Abdeckung befinden.
Konsistenz ist hier das, was das gesamte System prüfbar macht. Für P1- und P2-Alarme ist eine explizite Quittierung erforderlich, und der Zeitstempel sowie der Benutzer, der sie quittiert hat, müssen protokolliert werden. Genau dieser eine Datensatz macht oft den Unterschied aus zwischen einem rechtssicheren Vorfallbericht und einem Schulterzucken.
Regale erfordern dieselbe Disziplin: ein zeitlich begrenztes Einlagern mit einer obligatorischen Begründung und ein automatisches Auslagern nach Ablauf der Frist, damit nichts unbemerkt aus dem Blickfeld verschwindet. Vor dem Schließen müssen die Ursache, die ergriffene Korrekturmaßnahme und die tatsächliche Behebungszeit erfasst werden – und nicht nur ein Häkchen bei “behoben”. Wenn der Alarm auf einen mechanischen oder elektrischen Fehler hinweist, sollte der Workflow automatisch einen CMMS-Arbeitsauftrag erstellen oder verknüpfen, damit die Behebung bis zum Abschluss nachverfolgt wird, statt nur im Alarmprotokoll zu verbleiben.
Alarmmüdigkeit tötet mehr Alarmsysteme als schlechte Software. Bediener, die pro Schicht 200 Benachrichtigungen erhalten, hören auf, auch nur eine davon zu lesen, selbst diejenige, auf die es ankommt.
Führen Sie einen zwei- bis vierwöchigen Pilotbetrieb durch, bei dem Vorgesetzte jede generierte Alarmklassifizierung persönlich überprüfen und die Schwellenwerte basierend auf ihren Beobachtungen anpassen, anstatt sich auf die Annahmen der ursprünglichen Spezifikation zu verlassen. Wenn ein Messpunkt wiederholt auslöst, beheben Sie die zugrunde liegende Ursache (einen verschlissenen Sensor, eine schlecht eingestellte Totzone oder einen Prozess, der an seine Grenze driftet), anstatt den Alarm zu unterdrücken und zu hoffen, dass er von selbst verschwindet. Unterdrückung ohne Fehlerbehebung kaschiert lediglich ein echtes Problem.
Halten Sie die Regeln für die Zuweisung des P1-Status streng, denn die Verwässerung des Schweregrads ist einer der schnellsten Wege, um das Vertrauen in das System zu zerstören: Wenn alles kritisch ist, ist es nichts. Wöchentliche Schwellenwertüberprüfungen während der Anlaufphase fangen dies frühzeitig ab. Häufigkeits- und Dauerberichte für alle Ihre Alarmpunkte zeigen Ihnen, welche eine Hysterese-Anpassung benötigen, welche repariert und welche komplett neu gestaltet werden müssen., anstatt einer dauerhaften Abstimmung.
Metriken verwandeln das Alarmmanagement von einer reinen Compliance-Übung in einen echten Verbesserungshebel. Erfassen Sie die Zeit bis zur ersten Quittierung, die durchschnittliche Reparaturzeit (MTTR), die Alarmhäufigkeit pro Messstelle, die Wiederholrate und den Prozentsatz der Alarme, die unterdrückt statt behoben wurden. Eine steigende Unterdrückungsrate ist in der Regel ein Warnsignal dafür, dass die Schwellenwerte überprüft werden müssen.
Ausfallzeiten sind teuer, und die ersten Minuten bestimmen die Kosten. Ungeplante Ausfallzeiten belaufen sich bei großen Fertigungsunternehmen auf etwa 11% des Jahresumsatzes, und der Ausgang ist größtenteils bereits in den ersten Minuten nach Auslösen eines Alarms entschieden, noch bevor die meisten menschlichen Eingriffe überhaupt beginnen.
Vorfallberichte sollten immer die Geräte-ID, die Ausfalldauer, die Reaktionszeit und die ergriffenen Korrekturmaßnahmen enthalten, und zwar so konsistent strukturiert, dass man Pareto-Analyse über einen Monat von Vorfällen hinweg. Wöchentliche Zuverlässigkeitszusammenfassungen, die aus diesen Daten erstellt werden, zeigen Ihnen, welche Linien oder Maschinen zuerst die Aufmerksamkeit der Ingenieure verdienen, anstatt den Wartungsaufwand gleichmäßig im Werk zu verteilen.
Zu Beginn gleich das gesamte Werk alarmieren zu wollen, ist der Grund, warum Pilotprojekte unter ihrem eigenen Gewicht zusammenbrechen. Eine schrittweise Einführung hält die Arbeitsbelastung überschaubar und den Aufbau von Vertrauen authentisch.
Beibehalten die Regeln richtig.Pro-Tipp: Lassen Sie nicht zu, dass die Pilotlinie Ihre einfachste Linie ist. Wählen Sie eine mit einer echten Historie von Fehlalarmen, denn dort lernen Sie am meisten über Totbänder und die Abbildung des Schweregrads, bevor Sie skalieren.
An alarm nobody can read fast enough might as well not exist. Screen layout, colour coding and alert phrasing all determine how quickly an operator understands what’s happening and what to do about it, and this matters just as much as the underlying detection logic.
Alarms competing for attention on a cluttered HMI screen slow response, particularly during a flood when several conditions fire together. Consistent colour conventions (red genuinely reserved for critical, amber for urgent) help operators triage at a glance rather than reading every message in full. Alert text should state the equipment, the parameter and the expected action in plain language, not a cryptic tag code that only the engineer who wrote it understands.
Shift patterns matter too. Fatigue late in a night shift measurably slows acknowledgement times, which is one more reason escalation timers need to account for shift, not just elapsed time. Physical placement of Andon lights, radios and screens should follow where operators actually stand when a line stops, not where it was convenient to mount the hardware during commissioning.
Involving the operators who’ll actually use the system in the design workshop, rather than handing them a finished configuration, consistently produces alarm setups that get acknowledged faster and shelved less arbitrarily. People trust a system they helped build far more than one imposed on them, and that trust shows up directly in acknowledgement times once the pilot goes live.
An alarm flood happens when a single upstream event, a power dip, a sensor failure, a process excursion, triggers dozens or hundreds of downstream alarms within seconds. Tuning individual thresholds afterwards doesn’t fix a flood; it just changes which alarms fire.
The most common root cause is poor fault propagation logic: one root fault (a compressor tripping, say) cascades into alarms on every piece of equipment downstream that depends on it, none of which are actually broken. The fix is root cause suppression logic built into the alarm model itself, so dependent alarms are automatically linked to the trigger condition rather than firing independently.
Badly chosen deadbands are the second major cause, particularly on analogue signals sitting close to a limit. A flow reading oscillating around its low limit can generate an alarm every few seconds for hours. Fixing this means widening the deadband or adding a dwell time, not just acknowledging the same alarm repeatedly.
Equipment start-up and shutdown sequences are a third common trigger, since normal transients during a planned stop or restart often look identical to fault conditions to a poorly configured system. Building start-up and shutdown states into the alarm logic, so expected transients are suppressed automatically during those windows, removes a large share of flood events without touching a single threshold. Reviewing flood events specifically, rather than folding them into general alarm frequency reports, is the only way to spot these patterns.
The best-configured alarm system fails if operators don’t understand what each severity tier means or don’t trust the escalation chain to actually reach someone. Training is not a one-off induction session; it needs to be treated as ongoing competency development.
New operators need to learn the severity taxonomy before they touch a live line: what distinguishes a P1 from a P2, what acknowledgement actually commits them to, and when shelving is appropriate versus when it’s masking a problem. Skipping this step is how severity inflation creeps in, with operators marking everything critical because they were never taught the difference.
Refresher training matters just as much as initial onboarding, particularly after any change to thresholds or routing. An operator who learned the system eighteen months ago is working from an outdated mental model if thresholds have since moved. Competency checks tied to actual incident handling, not just a classroom quiz, give a far more honest picture of whether training has landed.
Cross-training across specialisms (electrical, mechanical, quality) also pays off directly in escalation performance, because a technician who understands why an alarm was routed to them responds faster than one who’s simply following an instruction. Building this understanding into onboarding, rather than assuming it develops naturally on the job, shortens the time it takes new hires to become reliable first responders.
Static thresholds catch problems after they’ve already started. Advanced analytics and predictive models aim to catch the drift before it crosses a limit at all, which changes the nature of the alert from reactive to genuinely preventive.
Pattern recognition across historical alarm data can flag when a machine’s behaviour resembles the lead-up to a past failure, even if no single parameter has breached its threshold yet. This kind of predictive alerting works best layered on top of solid source-side modelling, not instead of it. A model trained on noisy, badly classified alarm data will learn the noise as readily as the signal.
Anomaly detection also helps with the flood problem discussed earlier, by learning which combinations of alarms typically arrive together from a single root cause and automatically grouping them, so an operator sees one flagged event instead of forty. This is one of the more genuinely useful applications of AI in manufacturing right now, precisely because it works on data the plant is already generating rather than requiring new sensors.
The realistic expectation is incremental improvement, not a fully autonomous alarm system. Predictive analytics extends the reach of a well-designed alarm framework; it doesn’t replace the taxonomy, escalation rules or governance discussed earlier in this guide.
Consider a mid-sized packaging line running three shifts, where unplanned stoppages had been logged manually and inconsistently for years. The team’s first move wasn’t to buy new hardware; it was to run a severity taxonomy workshop with supervisors and map which alarms actually mattered against ISA-95 equipment codes. That single exercise revealed that over a third of logged “critical” stops were sensor faults, not process faults, a classic case of severity inflation.
During the pilot, supervisors reviewed every alert generated on one line for three weeks. They found that a single flow sensor accounted for roughly a fifth of all alarms fired that period, purely because its deadband was too tight. Widening it eliminated most of that noise overnight, with no change to escalation logic at all.
Escalation only became genuinely useful once contacts were mapped to specialisms rather than individuals. A hierarchical, time-based escalation approach that routes disturbances to defined solver groups rather than named people, tested in high-mix production environments, gave measurable improvements in responsiveness precisely because coverage didn’t collapse when a specific person was on leave. The pattern holds regardless of industry: get the taxonomy and the deadbands right first, then layer escalation and analytics on top.
Most failures trace back to two habits: skipping the pilot calibration because it feels slow, and letting severity creep upward until every alarm is marked critical. Both are avoidable with a short, disciplined review period and strict governance over who can change thresholds.
Mestric™ builds real-time alerting, escalation workflows and audit trails directly into its MES dashboards, which removes the disconnect between shop floor events and the KPI data managers actually review. A short pilot on one line, with simple, written governance rules, is the fastest way to find out whether your current setup is trustworthy.
— Andraž
Mestric™ builds real-time alerts, tiered escalation workflows, KPI dashboards and full audit trails directly into the shop floor data your machines already produce, which is precisely the setup this guide has walked through. Rather than bolting a separate notification tool onto your existing systems, Mestric™ connects to your equipment directly, models conditions properly, and routes them to the right person before a small stoppage turns into a costly one.
If your team is still chasing missed alarms in spreadsheets or WhatsApp threads, a working MES platform closes that gap without a lengthy overhaul. You can see how real-time performance tracking and alert escalation work together on an actual production line by requesting an onsite demonstration. Book that walkthrough now and bring one pilot line’s alarm history with you. It’s usually enough to show exactly where your current setup is losing time.


 069 763 552