

Prädiktive Instandhaltung ist eine zustandsorientierte Instandhaltung, die Sensoren und Analysen nutzt, um frühe Anzeichen von Ausfällen zu erkennen und Reparaturen zu planen, bevor es zu einem Ausfall kommt. Der Hauptvorteil sind weniger ungeplante Stillstände und eine messbare Steigerung der Gesamtanlageneffektivität (OEE). Sie funktioniert am besten bei kritischen, kostenintensiven oder im 24/7-Betrieb laufenden Anlagen, und die meisten Werke nutzen sie parallel zur präventiven Instandhaltung, anstatt diese vollständig zu ersetzen.
Kurzfassung:
- Sensoren müssen ordnungsgemäß installiert und kalibriert werden, um Fehlalarme zu vermeiden, die das Vertrauen in die Instandhaltung untergraben und die Systemzuverlässigkeit verringern.
- Ein erfolgreicher Pilot umfasst typischerweise die Auswahl kritischer Assets, die Definition klarer Erfolgsmetriken und das Sammeln von mehreren Wochen Basisdaten.
- Die vorausschauende Instandhaltung führt zu einer Kostensenkung von durchschnittlich 18% bis 31%, wobei die Ergebnisse je nach Branche, Anlage und Umsetzungsdisziplin variieren.
- Die Verknüpfung von Warnmeldungen zur vorausschauenden Wartung mit einem Fertigungsleitsystem gewährleistet rechtzeitige, datengestützte Arbeitsaufträge und minimiert Fehlalarme, die die Produktion beeinträchtigen.
- Um Zustimmung zu gewinnen, muss man klein anfangen, innerhalb von sechs bis zwölf Wochen greifbare Verbesserungen demonstrieren und Techniker frühzeitig in die Definition der Erfolgskriterien einbeziehen.
Die vorausschauende Wartung (Predictive Maintenance – PdM) basiert auf Live-Zustandsdaten anstelle eines festen Zeitplans. Sensoren überwachen eine Anlage kontinuierlich und speisen diese Daten in Analysesysteme ein, die Verschlechterungen kennzeichnen, bevor sie zu einem Ausfall führen, sodass Sie zum richtigen Zeitpunkt statt zum planmäßigen Zeitpunkt eingreifen können, laut Die Definition der vorausschauenden Wartung von IBM.
Die vorbeugende Wartung schlägt einen anderen Weg ein: Sie wartet Geräte in Zeit- oder Nutzungsintervallen, unabhängig davon, ob sie es benötigen oder nicht. Die reaktive Wartung, das älteste Modell, wartet einfach darauf, dass etwas kaputtgeht. Die vorausschauende Wartung liegt dazwischen und zielt darauf ab, Geld für Reparaturen nur dann auszugeben, wenn der Zustand der Geräte dies erfordert.
Signale korrespondieren typischerweise mit spezifischen Ausfallarten:
Nicht jedes Betriebsmittel verdient diese Behandlung. Günstige, leicht austauschbare Teile verbleiben in der Regel in einem präventiven Turnus, da sich die Investition in Sensoren niemals amortisieren würde. Ein hybrider Ansatz – zustandsbezogene Instandhaltung an Ihren kritischen Engpässen und vorbeugende Instandhaltung bei allem anderen – ist die Art und Weise, wie die meisten ausgereiften Anlagen tatsächlich betrieben werden.
Der wirtschaftliche Fall stützt sich auf drei Kostenblöcke: Ausfallzeiten, Ersatzteile und Notfalleinsätze. Ungeplante Stillstände sind nicht nur wegen des Produktionsausfalls teuer, sondern auch wegen Überstundeneinsätzen und eiliger Teilebestellungen zu Premiumpreisen. PdM greift alle drei an, indem es den Instandhaltungsteams wochenlange statt minutenlange Vorwarnzeiten gibt.
Die gemeldeten Kosteneinsparungen durch vorausschauende Instandhaltungsprogramme liegen zwischen etwa 18% und 31%, neben messbaren OEE-Gewinnen, laut Die Analyse der Vorteile von PdM durch ifm. Die tatsächlichen Ergebnisse variieren je nach Branche, Anlagenart und Disziplin bei der Umsetzung stark.
Das Hinweise des National Institute of Standards and Technology dass fortschrittliche Instandhaltungstechniken hohe Renditen erzielen können, warnt jedoch davor, dass Benchmarks auf nationaler Ebene nur begrenzt aussagekräftig sind und die Ergebnisse auf Unternehmensebene erheblich schwanken. Betrachten Sie jede Prozentangabe, die Sie lesen, einschließlich der oben genannten Spannen, eher als Richtwert denn als Garantie für Ihre spezielle Linie.
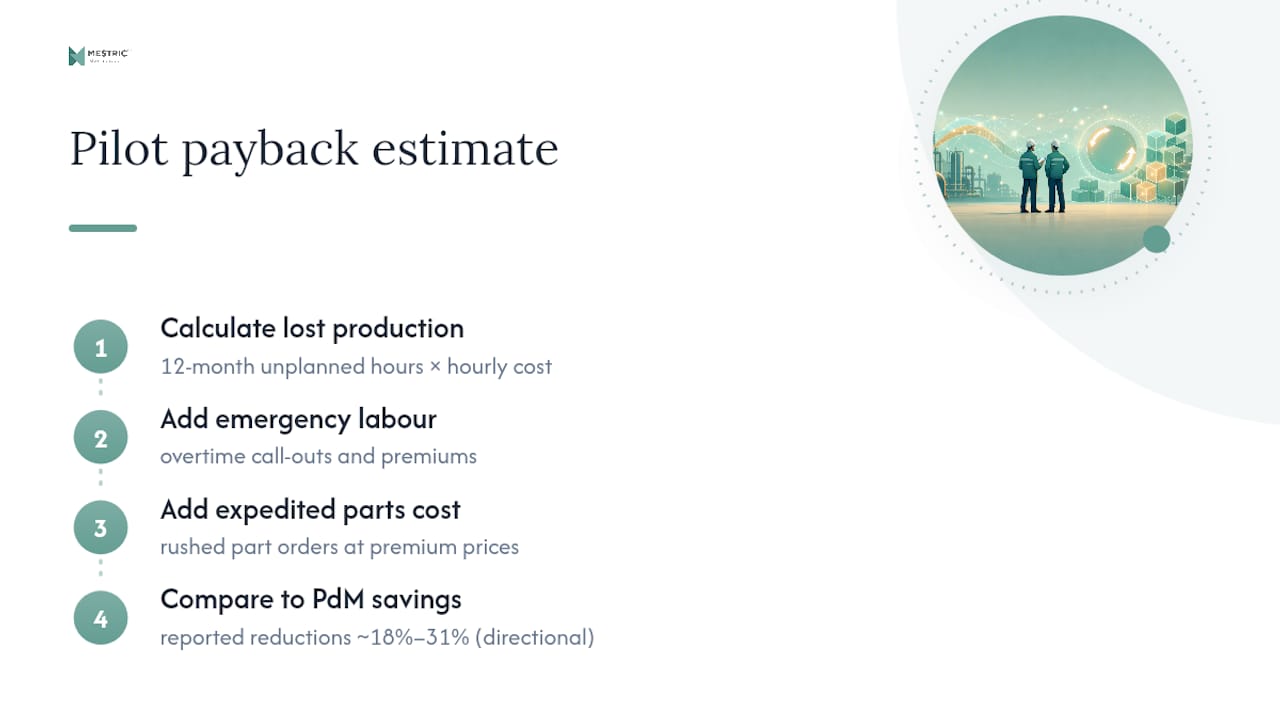
Um eine einfache Amortisationsschätzung für ein Pilotprojekt zu erstellen, zählen Sie die unplanmäßigen Ausfallzeiten Ihres Zielgeräts aus den letzten zwölf Monaten zusammen, multiplizieren Sie diese mit Ihren stündlichen Kosten für Produktionsausfälle und addieren Sie dann die Zuschläge für Notfalleinsätze von Arbeitskräften sowie die Kosten für Express-Ersatzteile. Diese Basislinie muss Ihr Pilotprojekt übertreffen. Tools wie die in Prädiktive Analytik für die Fertigung kann bei der Strukturierung dieses Vergleichs helfen, sobald Echtdaten fließen.
Ein funktionierendes PdM-System kombiniert Sensor-Hardware, eine Daten-Pipeline und eine Analyseschicht, die Messwerte in eine Warnung umwandelt. AWS beschreibt das Modell als IoT-Sensoren, maschinelles Lernen und Geschäftsdaten arbeiten zusammen Ausfälle vorherzusagen und die Wartung zum störungsärmsten Zeitpunkt in den Produktionsplan einzuplanen.
Die Sensorschicht umfasst typischerweise:
Edge-Analytik verarbeitet Daten nahe an der Maschine, was nützlich ist für hochfrequente Schwingungsmessungen, die ein Netzwerk überlasten würden, wenn sie als Rohdaten gesendet würden. Cloud-Analytik übernimmt die schwereren Modellierungen und anlagenübergreifenden Vergleiche und speist die Ergebnisse in Ihr CMMS oder MES ein, sodass eine gemeldete Anomalie automatisch zu einem Arbeitsauftrag wird. Nichts davon funktioniert ohne solide Ausgangswerte: Eine präzise Zeitstempelung, konsistente Abtastraten und saubere Anlagenmetadaten (Anlagen-ID, Installationsdatum, Kritikalitätsbewertung) ermöglichen es einem Modell, “normal” von “auf einen Ausfall zustrebend” zu unterscheiden.”
Eine Pilot-Einführung hält das Risiko gering und liefert Ihnen echte Nachweise, bevor Sie ein größeres Budget anfordern. Herstellerleitfäden und bewährte Branchenpraktiken verweisen übereinstimmend auf dasselbe Ausgangsprinzip: Wählen Sie einen kleinen, klar definierten Anwendungsbereich und beweisen Sie das Modell, bevor Sie skalieren.
Weisen Sie frühzeitig klare Verantwortlichkeiten zu: Ein Ingenieur oder ein Team sollte die Modellanpassung verantworten, und Instandhaltungsplaner müssen genau wissen, was eine Warnmeldung für ihren Zeitplan bedeutet. Rollen Sie das System Anlage für Anlage statt werksweit aus, damit die Lehren aus dem Pilotprojekt in die nächste Charge einfließen, anstatt doppelt gelernt zu werden.
Pro-Tipp: Führen Sie Ihren Pilotversuch an einer Anlage durch, die bereits eine dokumentierte Ausfallhistorie aufweist. Der Vergleich der Vorhersagen des Modells mit vergangenen Vorfällen bietet Ihnen eine schnelle und glaubwürdige Möglichkeit, die Genauigkeit vor einer breiteren Einführung zu validieren.
Die meisten Enttäuschungen im Bereich der vorausschauenden Wartung (PdM) lassen sich auf die Daten zurückführen, nicht auf die Algorithmen. Schlechte Sensormontage, inkonsistente Abtastraten und elektrisches Rauschen im Industrieumfeld sind die häufigsten Ursachen für Fehlalarme, und sie zerstören das Vertrauen schnell, laut Forbes’ Bericht über die Datenqualität in der vorausschauenden Wartung.
Ein lose verschraubter oder mit falscher Frequenz abtastender Sensor erzeugt Rauschen, das für ein untrainiertes Modell exakt wie ein frühes Ausfallsignal aussieht. Sorgen Sie zuerst für die richtige physische Installation; die Analyseschicht kann nur so gut sein wie das, womit sie gefüttert wird.
Die Zuverlässigkeit von Modellen hängt von einer geeigneten Baseline, beschrifteten Beispielen vergangener Ausfälle zum Trainieren und einem Re-Training-Zeitplan ab, der Drift erfasst, während die Ausrüstung altert oder sich die Betriebsbedingungen ändern. Sensor-Pipelines, beschrieben in Forschung zu lernbasierten Instandhaltungsstrategien führen typischerweise Anomalieerkennung, Fehlerdiagnose und Restlebensdauerschätzung als separate Phasen aus, von denen jede eine eigene Validierung erfordert.
Pro-Tipp: Beziehen Sie bei jeder frühen Warnung immer einen Menschen mit ein. Ein Instandhaltungsplaner, der die ersten fünfzig Warnungen anhand einer physischen Inspektion überprüft, verrät Ihnen mehr über Ihre Fehlalarmquote als jedes Dashboard.
Verfolgen Sie OEE, die mittlere Betriebszeit zwischen Ausfällen (MTBF), die mittlere Instandsetzungszeit (MTTR) und Ihre Fehlalarmquote und berichten Sie diese monatlich im Vergleich zu Ihrer Pilot-Baseline, damit die Beteiligten den Trend und nicht nur eine Momentaufnahme sehen.
Geplante Interventionen bringen einen echten Sicherheitsvorteil mit sich. Das planmäßige Reparieren eines defekten Lagers unter ordnungsgemäßen Lockout/Tagout-Verfahren ist sicherer als die Reaktion auf einen plötzlichen katastrophalen Ausfall., worauf auch Meggers Bericht über die Vorteile der vorausschauenden Wartung direkt hinweist. Teams benötigen zudem neue Fähigkeiten: das Lesen von Sensor-Dashboards, das Interpretieren von Modellkonfidenzwerten und das Koordinieren von Ersatzteilbestellungen anhand vorhergesagter Ausfallzeitfenster anstelle von festen Lagerbeständen. Plattform für das Sicherheitsmanagement in der Fertigung kann helfen zu formalisieren, wie geplante Interventionen die Exposition gegenüber Gefahren am Arbeitsplatz verringern.
Jedes PdM-Programm, das funktioniert, hat klein angefangen. Wählen Sie eine Anlagenklasse, weisen Sie innerhalb von sechs bis zwölf Wochen eine Verbesserung der OEE oder des MTTR nach, und nutzen Sie diese Belege, um die nächste Phase zu finanzieren. Zu versuchen, das gesamte Werk auf einmal mit Sensoren auszustatten, ist der mit Abstand häufigste Weg, gleichzeitig Budget und Glaubwürdigkeit zu verbrennen.
Die wirklichen Hindernisse sind selten technischer Natur. Das Vertrauen in Daten schwindet, wenn sich die ersten Alarme als Fehlalarme erweisen. Vage definierte ROI-Kriterien laden nach Ende des Pilotprojekts zu endlosen Debatten ein. Und Wartungstechniker, die sich zwanzig Jahre lang auf ihr Bauchgefühl verlassen haben, werden sich gegen ein Dashboard wehren, das ihnen sagt, wann sie handeln müssen – es sei denn, sie waren von Tag eins an daran beteiligt, zu definieren, wie “funktionieren” aussieht.
— Andraž
Prädiktive Wartungswarnungen stiften erst dann einen Wert, wenn sie mit dem verknüpft werden, was die Produktion tatsächlich damit macht. Ein Manufacturing Execution System ist die Ebene, die eine sensorbasierte Warnung mit einem realen Arbeitsauftrag, den Live-Leistungsdaten einer Maschine und den Ausfallkosten verbindet, die bei Ignorieren entstanden wären.
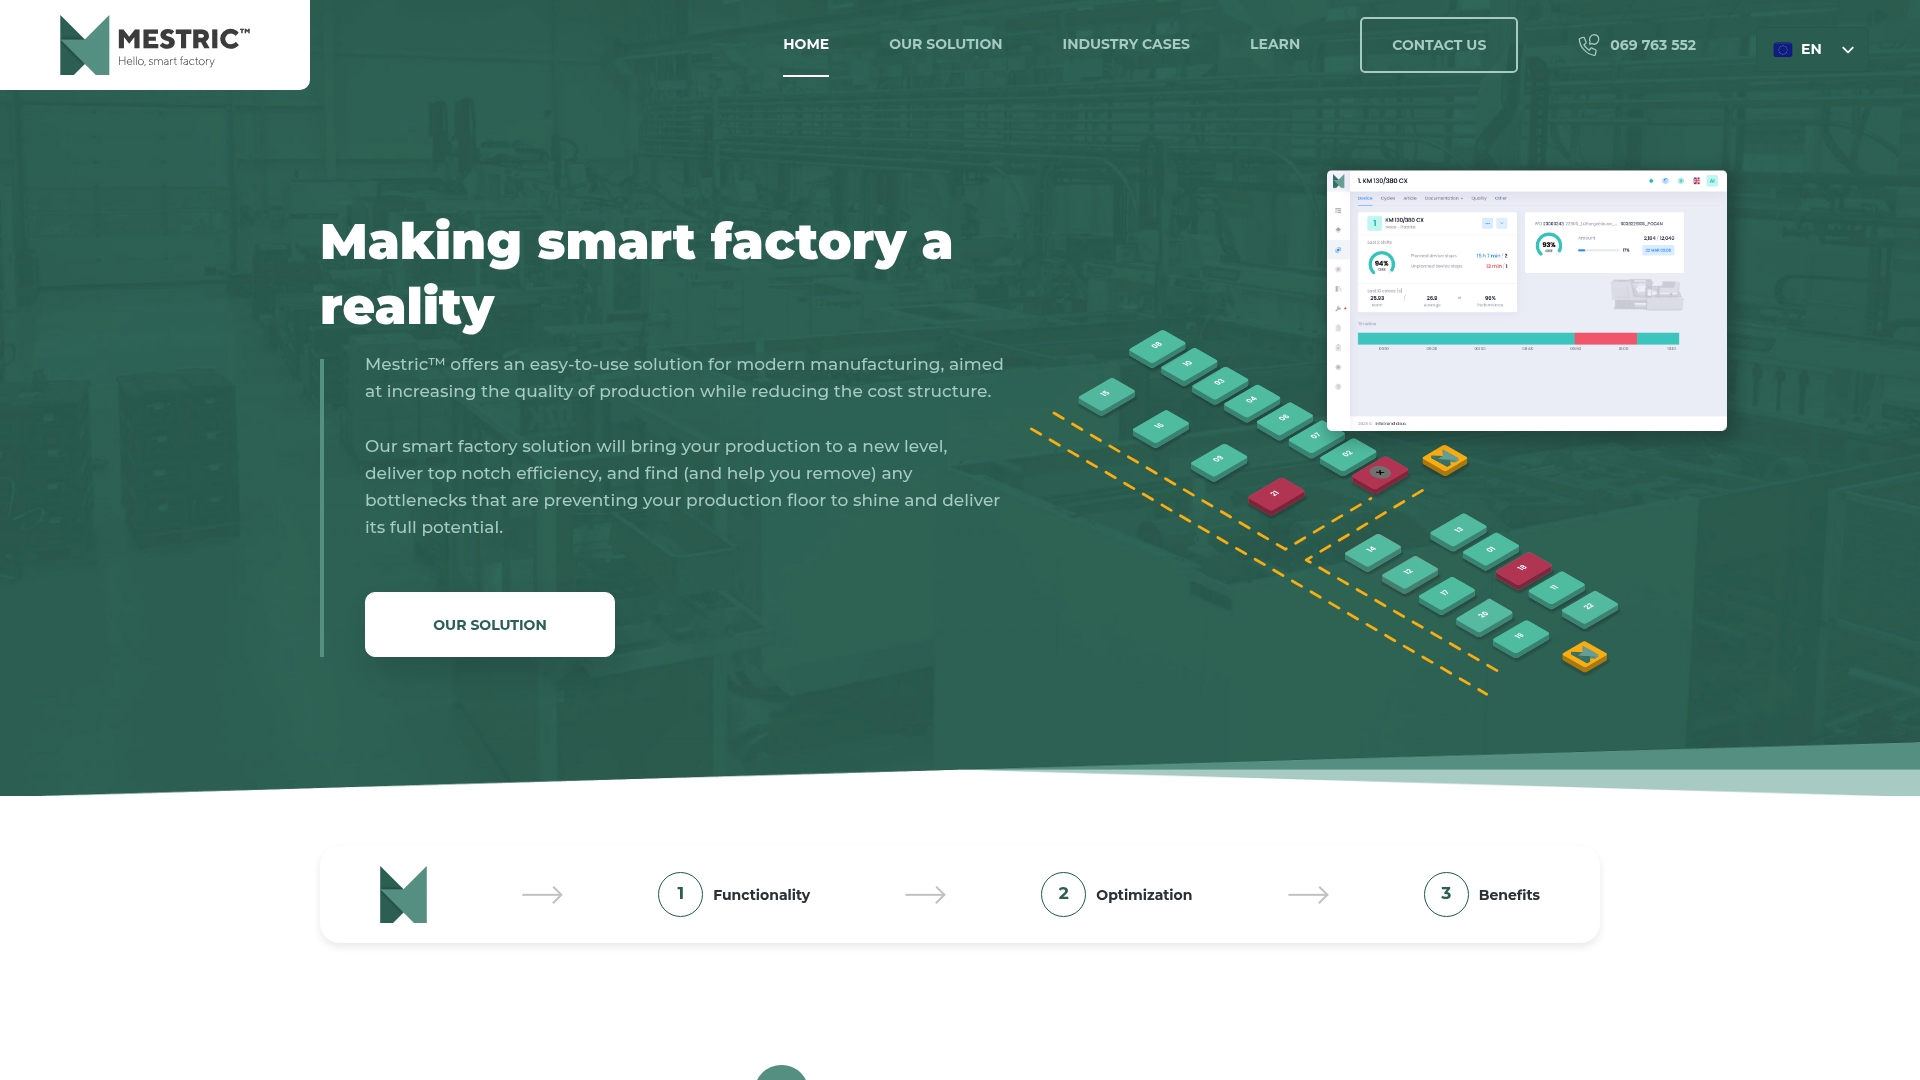
Die Plattform verbindet sich direkt mit Anlagen in der Fertigung und führt Leistungskennzahlen, Ausfallzeiten und Qualitätsparameter zusammen mit Wartungssignalen in einer einzigen Ansicht zusammen, anstatt sie auf separate Tools zu verteilen. Das ist wichtig, weil ein Fehlalarm, der frühzeitig anhand echter Produktions-KPIs erkannt wird, Sie nichts kostet, während ein in einem reinen Wartungstool verstecktes Problem tagelang ungelöst bleiben kann. KI-gestützte Optimierungstools helfen dabei, aufzudecken, welche Engpasste tatsächlich die Produktion belasten, und liefern ein klareres Vorher-Nachher-Bild als reine Ausfallprotokolle. Wenn Sie Plattformen für diese Art der Integration vergleichen, MES im Vergleich zu traditionellen Fertigungsansätzen lohnt sich vor einer Verpflichtung zu lesen. Buchen Sie eine Vor-Ort-Demonstration, um zu sehen, wie vernetzte Maschinendaten auf Ihren eigenen Produktionslinien aussehen würden.
Für eine tiefergehende technische Fundierung über diesen Leitfaden hinaus decken diese Quellen die Standards, die Forschung und die praktischen Details ab, die die aktuelle PdM-Praxis prägen:


 069 763 552