


Kurzfassung:
- Die Datenverwaltungssteuerung in der Fertigung ist ein strukturierter Rahmen aus Richtlinien, Rollen und Tools, der die Datenqualität und Vertrauenswürdigkeit gewährleistet. Sie hilft, Fehler zu verhindern, die operative Effizienz zu verbessern und die Einhaltung von Vorschriften in industriellen Umgebungen zu unterstützen. Die Implementierung von auf einer starken Datenarchitektur basierenden, aufgliederten und automatisierten Governance-Praktiken verbessert die KI-Performance und die Gesamtergebnisse der Fertigung.
Die Datenverwaltung in der Produktion wird als formalisiertes Rahmenwerk aus Richtlinien, Rollen, Validierungsregeln und Tools definiert, das die Erstellung, Verwaltung und Nutzung von Industriedaten innerhalb einer Organisation steuert. Ohne diese Struktur basieren Produktionsentscheidungen auf Daten, die unvollständig, inkonsistent oder einfach falsch sind. Diese Disziplin steht im Mittelpunkt der modernen Datenmanagement-Methoden in der Produktion und ihr Wichtigkeit hat sich stark erhöht, da KI- und Industrie 4.0-Systeme Daten erfordern, die nicht nur verfügbar, sondern auch vertrauenswürdig sind. In diesem Artikel werden die Kernkomponenten, die technische Architektur, die Automatisierungsverfahren sowie die praktischen Vorteile der Datenverwaltung in der Produktion behandelt, damit Sie Ihr eigenes Vorgehen mit Sicherheit aufbauen oder verbessern können.
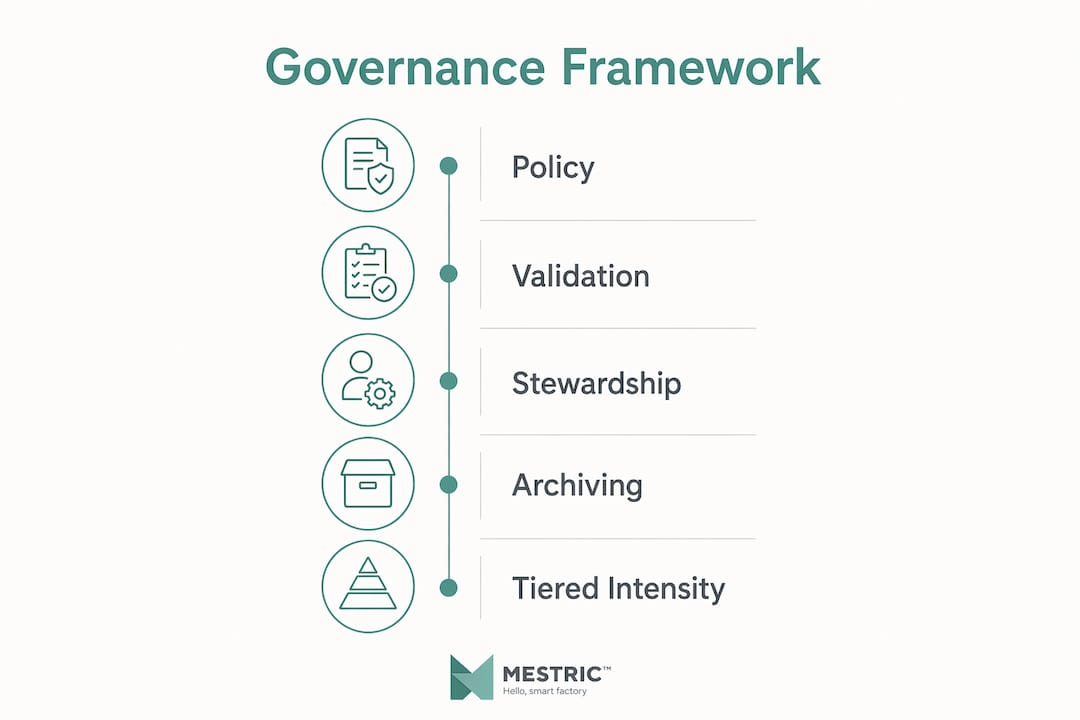
Die Datenverwaltung in der Fertigung ist die strukturierte Disziplin, die die Eigentumsvergabe, die Einhaltung von Qualitätsstandards und die Festlegung der Datenflüsse von der Maschine zu Entscheidungen regelt. Dieser Begriff wird manchmal lockerer verwendet, doch die anerkannte Branchendefinition konzentriert sich auf vier Säulen: klare Datenrichtlinien, Validierungsprozesse, definierte Verantwortungsrollen und maßgeschneiderte Tools. Jede dieser Säulen befasst sich mit einem anderen Versagenspunkt in der Datenkette.
Die Konsequenzen sind hoch. Data Governance ist eine entscheidende operative Strategie, Dies ist keine Compliance-Maßnahme, die die Abfallraten, die Wartungsplanung und die Produktionsleistung direkt verbessert. Das bedeutet, dass ein schlecht verwaltetes Datenmodell nicht nur Probleme bei der Berichterstattung verursacht, sondern auch zu schlechten Bauteilen, verpassten Wartungsintervallen und fehlerhaften KI-Prognosen führt.
Hersteller stehen zudem vor regulatorischen Druck. Die Auditbereitschaft erfordert, dass Aufzeichnungen aufbewahrt und nachvollziehbar sind, und Siebenjährige Archivierung Dies ist die Standardempfehlung für EDI- und ERP-Daten in Produktionsumgebungen. Das ist eine lange Zeit, um die Datenintegrität zu gewährleisten, ohne eine formale Governance-Struktur zu implementieren.
Eine effektive Datenverwaltung in EDI-ERP basiert auf vier Säulen, die für alle Bereiche der Fertigungsdatenmanagement-Infrastruktur gleichermaßen gelten.
Außerhalb dieser vier Säulen nutzen führende Hersteller eine abgestufte Governance-Stärke, um die Anstrengungen realistisch zu steuern. Stufenförmige Frameworks wie Gold, Silber und Bronze Geben Sie den kritischen Bereichen wie Finanzen und Qualität die strengste Governance-Richtlinie zu, während Sie für Daten mit geringerer Priorität weniger strenge Regeln anwenden. Auf diese Weise wird der Burnout der Stakeholder verhindert und die Governance bleibt dort konzentriert, wo sie am wichtigsten ist.
Pro-Tipp: Starten Sie Ihr hierarchisches Framework, indem Sie Ihre fünf wichtigsten Datenbereiche nach Unternehmensrisiko aufgeführt werden. Legen Sie die Governance für Gold nur diesen Bereichen zu. Alles andere kann auf Silber oder Bronze eingestellt werden und kann im Zuge der Kapazitätssteigerung auf Gold umgestellt werden.
Ein Governance-Framework ist nur so stark wie die Datenarchitektur dahinter. Vier strukturelle Praktiken machen den Unterschied zwischen einem Framework, das hält, und einem, der unter realer betrieblicher Belastung zusammenbricht.
Pro-Tipp: Versuchen Sie nicht, Analysetools mit Rohdaten des Systems zu verbinden, bevor die Arbeit mit dem Asset-Master und der Taxonomie abgeschlossen ist. Jeder Bericht, der auf nicht aufgelösten Identifikatoren basiert, muss neu erstellt werden.
| Architektur-Layer | Ziel | Gängige Fehler ohne diese |
|---|---|---|
| Asset-Master | Stabile Geräte-IDs für das gesamte Unternehmen | Doppelverwendung von Assets in verschiedenen Berichten |
| Ereignis-Taxonomie | Vereinheitlichtes Status- und Misserfolgswortschatz | Inkonsequente Klassifizierung von Ausfallzeiten |
| Zeitnormalisierung | Gleichgerichtete Zeiteingabepunkte in MES, ERP und PLC | Unzuverlässige Zeitreihenanalyse |
| Archivierungsstruktur | Audit-ready retention with version history | Compliance gaps and data loss |
Understanding how digital manufacturing frameworks handle data architecture helps contextualise why these layers are non-negotiable in a modern plant.
Automated validation at the point of data ingestion is the single most effective practice for maintaining data quality in manufacturing. Validation rules that quarantine physically impossible data prevent erroneous inputs from ever reaching your analytics or AI models. A classic example: machine RPMs exceeding 500,000 are automatically blocked, because no production equipment operates at that speed. The rule costs almost nothing to implement and prevents corrupted training data from degrading AI model performance.
This matters because AI systems in manufacturing amplify whatever data quality exists beneath them. In cloud ERP and Industry 4.0 environments, governance failures do not stay contained. They scale. A single bad sensor reading that passes validation can propagate through predictive maintenance models, production schedules, and supplier orders before anyone notices.
Passive oversight is outdated. Automated validation and archive tools alert stakeholders in real time to data failures, transforming governance from a background compliance function into an active operational amplifier that protects every system that depends on your data.
The practical implication for your team is clear. Governance rules must be embedded in the data pipeline, not applied manually after the fact. EDI and ERP integrations need consistent validation schemas at every connection point. Archival processes must trigger automatically, not depend on someone remembering to run a script. The role of AI in manufacturing depends entirely on this foundation being solid before any model is trained or deployed.
The operational benefits of data governance in manufacturing are concrete and measurable across multiple functions.
Das role of data in manufacturing is not passive. Governed data actively drives efficiency gains across every function that touches production. Manufacturers who treat data quality as an operational priority, rather than an IT concern, consistently outperform those who do not.
Pro-Tipp: Track your root cause analysis cycle time before and after implementing governance rules. A reduction in that metric is one of the clearest early signals that your governance programme is working.
Successful implementation of data governance in manufacturing follows a pattern that is more cultural than technical. Real success comes when governance shifts from IT-driven fixes to business-led ownership, with C-suite engagement driving accountability from the top down.
Pro-Tipp: Pilot your governance framework on one plant and one data domain before scaling. A successful pilot creates internal advocates who make the broader rollout far easier to sell to sceptical stakeholders.
Integrating governance with manufacturing data integration strategy ensures that the infrastructure and the governance rules evolve together, rather than creating technical debt that undermines both.
Manufacturing data governance succeeds when it combines business-led ownership, automated validation at ingestion, tiered intensity frameworks, and a solid asset master architecture built before any analytics layer is deployed.
| Punkt | Details |
|---|---|
| Four governance pillars | Policies, validation, stewardship roles, and archiving tools form the non-negotiable foundation. |
| Tiered intensity frameworks | Gold, Silver, and Bronze tiers focus effort on critical domains and prevent stakeholder burnout. |
| Asset master and taxonomy first | Resolve equipment IDs and unify event vocabularies before building any analytics or AI layer. |
| Automated validation at ingestion | Rules that block impossible data points protect AI models and prevent errors from scaling. |
| Business-led ownership | C-suite engagement and defined steward roles transform governance from IT task to operational priority. |
I have spent years watching manufacturers invest heavily in analytics platforms and AI tools, only to find that the outputs are unreliable. The diagnosis is almost always the same: the data feeding those systems was never properly governed. The technology was not the problem. The foundation was.
What strikes me most is how rarely governance appears on the agenda at the leadership level. It gets delegated to IT, treated as a compliance checkbox, and reviewed only when something goes wrong. That is the wrong sequence entirely. The manufacturers who get the most from their digital investments are the ones where a senior leader genuinely owns data quality as a business outcome, not a technical deliverable.
The tiered intensity approach is the most pragmatic framework I have seen for making governance real in a manufacturing context. Trying to apply Gold-level rigour to every data domain simultaneously is a reliable way to exhaust your team and produce nothing. Starting with your highest-risk domains, getting those right, and expanding deliberately is how you build something that lasts.
The other shift worth making is treating governance as part of your digital transformation, not a prerequisite that must be completed first. Embed it into your ERP migration, your MES rollout, your PLM implementation. That is where the effort is already happening. That is where governance rules will actually stick.
— Andraž
Mestric connects directly to your manufacturing equipment and gives production managers a real-time view of quality parameters, downtime, and performance KPIs. That visibility depends on the same data quality principles covered in this article. Mestric’s platform enforces consistent data capture at the machine level, reducing the manual errors that undermine governance programmes before they get started. If you are building or improving your governance approach, the step-by-step production quality guide from Mestric gives you a practical framework for aligning quality monitoring with your data governance goals. You can also explore Produktionsqualitätsüberwachung to see how real-time data capture supports the kind of audit-ready, validated data records that governance frameworks require.
Manufacturing data governance is a formalised framework of policies, roles, validation rules, and archiving practices that controls how industrial data is created, maintained, and used. It assigns accountability for data quality to named individuals and enforces standards at every point in the data pipeline.
The four pillars are clear data policies, validation before data enters core systems, defined data steward roles, and fit-for-purpose archiving tools. All four are required for governance to be enforceable and audit-ready.
Building a manufacturing data foundation typically takes 6–12 months for multi-plant networks, with the first four weeks focused on core asset masters and event taxonomies.
AI models trained on ungoverned data produce unreliable outputs. Automated validation rules that block physically impossible data points at ingestion protect model integrity and prevent errors from scaling across connected systems.
Tiered governance intensity assigns Gold, Silver, or Bronze rigour to different data domains based on business risk. Gold governance applies to critical areas such as Finance and Quality, while lower-priority domains receive lighter-touch rules to preserve team capacity.


 069 763 552