

MQTT ist ein geeignetes, leichtgewichtiges Messaging-Protokoll für Produktionsumgebungen und funktioniert am besten in Kombination mit einem Edge-Gateway, einem Broker und einer ordnungsgemäßen MES-Integration. Es bietet einen skalierbaren, bidirektionalen Datenfluss zwischen Maschinen und Software ohne großen Netzwerk-Overhead. Der praktische nächste Schritt ist kein werksweiter Rollout: Testen Sie eine Maschine mit einem einzigen Gateway und Broker, weisen Sie den Datenfluss nach und skalieren Sie dann.
Kurzfassung:
- Lokale Broker in der Nähe von Maschinen sorgen für eine geringe Latenz bei der Echtzeitsteuerung und -überwachung, während zentrale Broker Unternehmensanalysen und Berichte unterstützen.
- Die Durchführung von Pilotprojekten auf kostengünstiger Hardware wie dem Raspberry Pi und der anschließende Umstieg auf Geräte in Industriequalität kostet bei großem Maßstab in der Regel etwa 1.000 US-Dollar pro Gerät, abhängig von der Verkabelung und den vorhandenen Ressourcen.
- Die Sicherung von MQTT umfasst die Aktivierung von TLS, die Verwendung einer zertifikatsbasierten Authentifizierung und die Implementierung von Zugriffskontrollen auf Themenebene, um Sicherheitslücken zu verhindern.
- Eine ordnungsgemäße Themenhierarchie, QoS-Einstellungen und ein phasenweiser Pilotversuch sind unerlässlich, um Betriebsausfälle und übermäßige Bandbreitennutzung bei groß angelegten Implementierungen zu vermeiden.
- Die Integration von MQTT mit Legacy-Protokollen wie Modbus oder OPC UA erfordert sorgfältige Übersetzungsschichten, die gut dokumentiert sein sollten, um langfristige Wartungsprobleme zu vermeiden.
MQTT arbeitet nach einem Publish/Subscribe-Modell. Eine Maschine (oder deren Gateway) veröffentlicht eine Nachricht zu einem Topic auf einem Broker; alles, was diesen Topic abonniert hat, empfängt sie sofort, ohne direkte Verbindung zwischen Sender und Empfänger. Genau diese Entkopplung macht MQTT in der Produktion so viel einfacher zu verwalten als die Punkt-zu-Punkt-Integrationen, die ältere SCADA-Setups dominieren.
Des Protokolls drei Dienstgütestufen, Auf einer Werkshalle sind gespeicherte Nachrichten und persistente Sitzungen wichtiger als anderswo. QoS 0 sendet und vergisst, QoS 1 garantiert die Zustellung, erlaubt aber Duplikate, und QoS 2 garantiert genau eine Zustellung auf Kosten zusätzlicher Handshakes. MQTT 5 bietet im Vergleich zu MQTT 3.1.1 eine detailreichere Fehlerberichterstattung und Nachrichtengültigkeit, und das Protokoll besitzt den ISO-20922-Standardstatus, was wichtig ist, wenn Beschaffungsteams fragen, ob eine Technologie an einen Anbieter gebunden oder wirklich offen ist.
Warum Hersteller sich immer wieder dafür entscheiden:
Wo Sie den Broker platzieren, bestimmt, wie sich das gesamte System verhält. Ein lokaler Broker in der Nähe der Maschinen sorgt für schnelle Reaktionszeiten bei HMI und SCADA, da Nachrichten das Werksnetzwerk nie verlassen. Ein zentraler oder Cloud-Broker hingegen ist für Unternehmensberichte und standortübergreifende Analysen konzipiert, bei denen Latenzen von einigen Hundert Millisekunden unerheblich sind.
Die meisten Produktionsbereitstellungen kombinieren am Ende beides und sehen ungefähr so aus:
plant/line1/machine3/telemetry bedeutet auf jeder Website dasselbe.Viele Anlagen betreiben MQTT zusätzlich zu OPC UA statt an seiner Stelle. MQTT übernimmt den leichtgewichtigen Telemetrietransport; OPC UA liefert das reichhaltigere semantische Datenmodell dort, wo Maschinen es benötigen.
Überspringen Sie die unternehmensweite Einführung am ersten Tag. Jede dokumentierte Erfolgsgeschichte im Bereich des industriellen MQTT beginnt im Kleinen und wird erst dann ausgeweitet, wenn sich die Grundlagen bewährt haben.
Eine der besser dokumentierten industriellen Implementierungen – die von „Automation World“ berichtete Einführung bei MTNA – wurde zunächst auf einem Raspberry Pi prototypisiert, bevor auf Opto 22 groovRIO-Geräte umgestellt wurde; dabei wurden nach der standortübergreifenden Skalierung implementierte Kosten von etwa $1.000 US-Dollar pro Maschine angegeben. Diese Zahl dient eher als nützlicher Anhaltspunkt für die Planung als als allgemeingültiger Richtwert, da sowohl die Komplexität der Verkabelung als auch das Alter der vorhandenen SPS diesen Wert beeinflussen.
Pro-Tipp: Führen Sie den Piloten auf der Maschine mit der schlechtesten bestehenden Sichtbarkeit durch, nicht auf der am einfachsten zu verkabelnden. Dort schreibt sich der Business Case für die Expansion von selbst.
Bevor Sie eine zweite Maschine berühren, bestätigen Sie die Pilot validiert Namens- und QoS-Konventionen Sie beabsichtigen, überall sonst wiederzuverwenden. Thema-Strukturen nachträglich auf zwanzig Maschinen anzupassen, ist weitaus kostspieliger, als sie bei einer einzigen richtig zu machen.
Ein offener oder durch ein gemeinsames Passwort, das jeder auf der Etage kennt, geschützter MQTT-Broker ist kein hypothetisches Risiko. Er gehört zu den am häufigsten dokumentierten Fehlkonfigurationen in industriellen Anwendungen, und das ist völlig vermeidbar.
Pro-Tipp: Reservieren Sie die Zustellung “genau einmal” für Befehle, nicht für hochfrequente Telemetriedaten. HiveMQ selbst Modernisierungsleitfaden behandelt QoS 2 als Komplexitätskosten, die sich nur dort zu zahlen lohnen, wo eine doppelte Zustellung echten Schaden anrichten würde.
Der Wert zeigt sich am schnellsten in der Fertigung, nicht auf einer Folie im Vorstandszimmer. Sobald Telemetriedaten kontinuierlich fließen, statt stündlich von Hand protokolliert zu werden, schließen sich die Lücken zwischen dem, was passiert ist, und dem, was jemand aufgezeichnet hat.
Eine schnellere Fehlererkennung ist das Ergebnis, das die meisten Ingenieure als Erstes bemerken. Wenn ein Anstieg von Vibration oder Temperatur innerhalb von Sekunden statt erst am nächsten Morgen in einem Schichtbericht gemeldet wird, verkürzt sich das Reaktionsfenster von Stunden auf Minuten. Erfahren Sie, wie Echtzeitüberwachung führt zu messbaren Gewinnen, sobald die Daten-Pipeline eingerichtet ist.
Die meisten fehlgeschlagenen Implementierungen scheitern nicht, weil MQTT das falsche Protokoll ist. Sie scheitern an vermeidbaren operativen Entscheidungen, die unter Zeitdruck getroffen wurden.
Jede einzelne davon ist eine Designentscheidung und keine Einschränkung des Protokolls selbst, weshalb eine bewusste Pilotphase in jedem ernsthaften Implementierungsplan ihren Platz verdient.
Die meisten Fabriken fangen nicht bei Null an. Modbus, Profibus und alternde SPSen, die proprietäre Kontaktplanlogik ausführen, erledigen nach wie vor die eigentliche Arbeit in der Halle, und keine von ihnen spricht von Haus aus MQTT.
Die praktische Antwort ist ein Edge-Gateway, das übersetzt. Es liest Signale des Legacy-Protokolls auf der einen Seite ein und veröffentlicht sie auf der anderen Seite als MQTT-Topics, ohne die eigene Steuerungslogik der Maschine zu berühren. Dieser nicht-invasive Ansatz ist wichtiger, als es klingt: E/A-Abgriffe statt Code-Modifikationen halten das Produktionsrisiko gering, da niemand die Logik auf einer SPS umschreibt, die seit fünfzehn Jahren unbeaufsichtigt läuft.
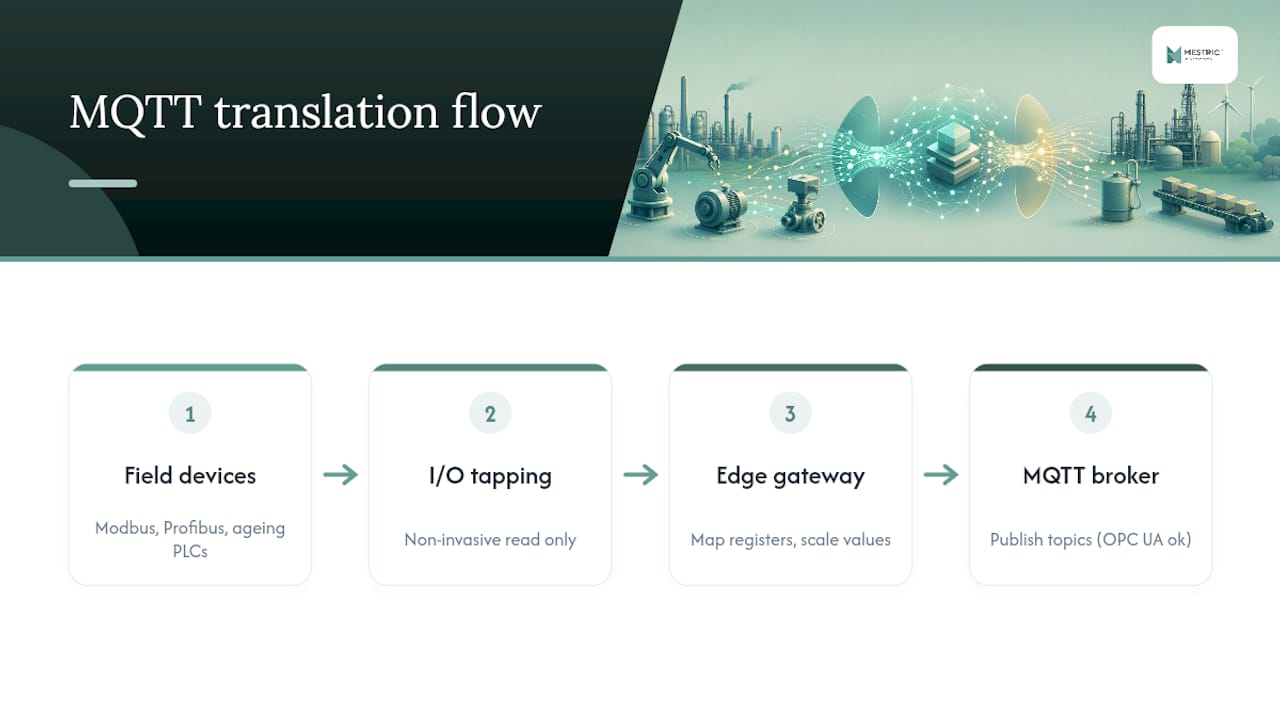
Wenn die Geräte bereits OPC UA unterstützen, ist die Aufgabe des Gateways einfacher: OPC UA-Server können oft direkt in einen MQTT-Broker publizieren, wodurch Sie die semantische Reichhaltigkeit des OPC UA-Datenmodells zusammen mit dem leichtgewichtigen Transport von MQTT erhalten. Wenn die Geräte nur Modbus sprechen, müssen Sie Register manuell auf Topic-Namen abbilden, was eine mühsame, aber vorhersehbare Arbeit ist.
Der Fehler, den man unbedingt vermeiden sollte, ist, die Protokollübersetzung als einmaliges Skript zu betrachten. Dokumentieren Sie jede Zuordnung (Register, Topic, Einheit, Skalierungsfaktor) während des Erstellens, denn die Person, die das System in drei Jahren wartet, wird es nicht geschrieben haben, und Modbus-Registertabellen sind ohne Notizen bekanntermaßen undurchsichtig. Grundlagen der digitalen Fertigung ist es wert, gelesen zu werden, wenn Ihr Engineering-Team abwägt, wie weit es modernisieren soll, bevor Altanlagen angetastet werden, im Vergleich dazu, eine Übersetzungsschicht auf unbestimmte Zeit zu betreiben. In der Praxis betreiben die meisten Anlagen die Übersetzungsschicht viel länger als geplant, einfach weil das Ersetzen funktionierender Althardware selten die Kosten-Nutzen-Schwelle erreicht.
Eine einzige Maschine, die jede Sekunde Telemetriedaten sendet, generiert in einer Woche mehr Daten als die meisten manuellen Protokollierungssysteme in einem Jahr erzeugt haben. Zu entscheiden, was aufbewahrt werden soll und wo, ist ebenso wichtig wie dafür zu sorgen, dass die Nachrichten überhaupt fließen.
Rohe MQTT-Nutzdaten sind keine Datenbank. Die Aufgabe des Brokers ist der Transport, nicht die Speicherung, weshalb jede ernsthafte Implementierung Nachrichten sofort nach deren Eintreffen in eine Persistenzschicht leitet. Zeitreihendatenbanken sind die gängige Wahl für Telemetriedaten, da sie im Gegensatz zu einer relationalen Mehrzweckdatenbank, die für dieselbe Aufgabe verwendet wird, darauf ausgelegt sind, hochfrequente Schreibvorgänge und zeitbasierte Abfragen effizient zu verarbeiten.
Eine sinnvolle Struktur trennt Daten nach Zweck, anstatt alles in eine einzige Tabelle zu werfen:
Eine Aufbewahrungsrichtlinie verdient eine bewusste Entscheidung und keine Standardeinstellung. Jede rohe QoS-0-消息 (Bitte Nachricht) für immer zu behalten, lohnt sich selten wegen der Speicherkosten, wenn eine downsamplierte oder aggregierte Version Berichterstellungsanforderungen genauso gut erfüllt. Was niemals downsampliert werden sollte, ist alles, was in ein Qualitäts- oder Sicherheitsprotokoll einfließt, bei dem die ursprüngliche Auflösung später benötigt werden könnte. Mapping how collected data feeds decision-making before you finalise a storage strategy avoids rebuilding it six months in, once someone asks for a report the raw pipeline was never designed to answer.
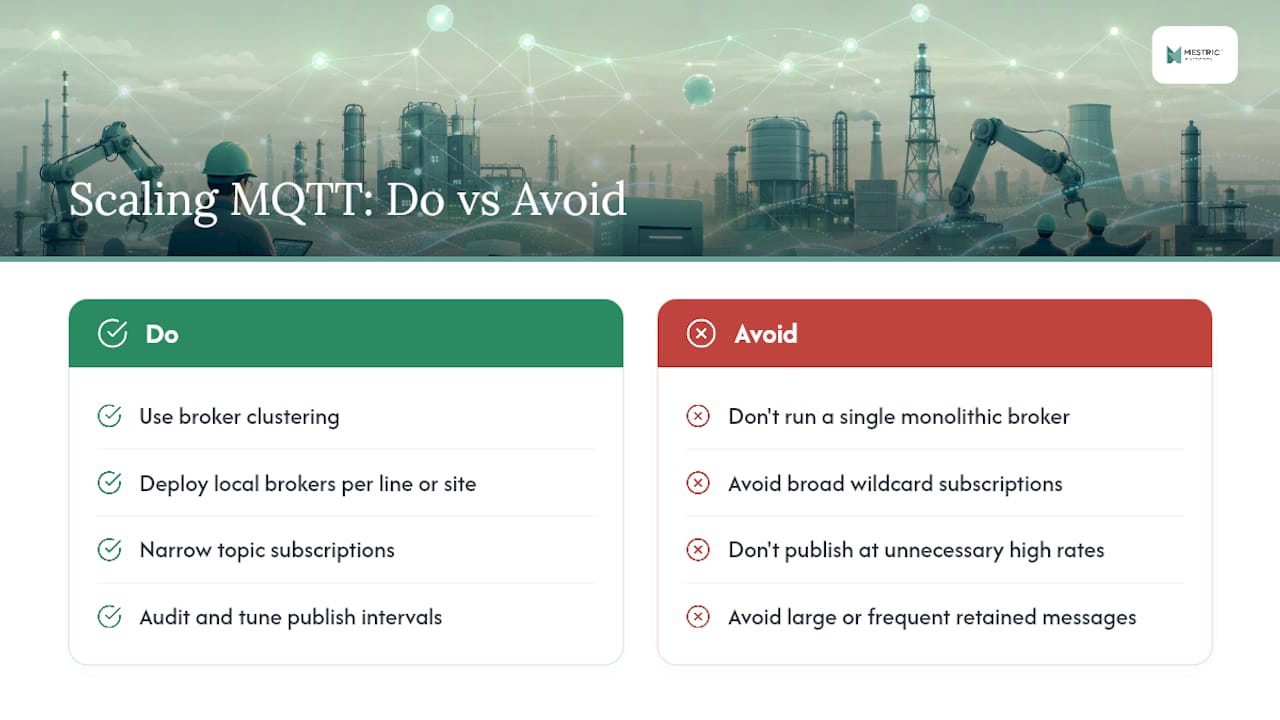
What works cleanly for five machines can strain badly at fifty. The usual bottleneck is not the protocol itself but the number of open connections, the size and frequency of retained messages, and how many subscribers are pulling from the same busy topics.
Broker clustering is the standard answer. Rather than one broker handling every connection, a cluster distributes load across nodes and keeps the system running if one node drops, a pattern HiveMQ documents in detail for enterprise-scale unified namespace deployments. Local brokers per line or per site, bridged upward to a central cluster, tend to outperform a single monolithic broker serving the whole plant, because local traffic never has to leave the local network to reach its first subscriber.
Topic design becomes a performance question at scale, not just an organisational one. Wildcard subscriptions across an entire plant’s namespace look convenient during development, but they become expensive once hundreds of machines are publishing simultaneously, since every subscriber processes every matching message whether it needs it or not. Narrowing subscriptions to what a given dashboard or system genuinely consumes keeps broker load predictable as machine count grows.
Message frequency is worth auditing before it becomes a problem. A sensor publishing every 100 milliseconds because that was the default, rather than because anything downstream needs that resolution, is a common and avoidable source of unnecessary broker load. Tuning publish intervals to match what the consuming system actually uses, rather than what the sensor is technically capable of, is one of the cheapest scalability wins available.
Raw MQTT messages are not insight. Somewhere between the broker and the person making a decision, that data needs to become a chart, an alert, or a trend line someone can act on.
Time-series visualisation platforms are the common layer directly above the broker, built to query high-frequency data and render it as live dashboards without the lag of a traditional business intelligence tool. Above that sits the analytics layer, where telemetry gets combined with quality and downtime records to answer questions no single machine’s data stream could answer alone, such as which shift, which operator pattern, or which upstream process correlates with a defect spike.
For predictive maintenance, the same MQTT streams that feed a dashboard can feed a machine learning model, since brokers are well placed to route data into both destinations simultaneously without duplicating the connection to the machine itself. The practical choice most plants face is not whether to build custom visualisation, but whether to connect MQTT into a platform that already understands manufacturing KPIs, rather than building OEE and downtime logic from scratch on top of a generic charting tool. That is precisely the layer where an MES earns its place in the stack, turning a topic full of numbers into a metric a production manager actually uses.
The flow is straightforward: a machine publishes to its edge gateway, the gateway forwards to a broker, and an MES subscribes to the relevant topics to build live KPIs. That is the practical route from raw telemetry to a dashboard a production manager actually checks.
The system takes that subscribed data and turns it into downtime analysis, quality monitoring and cost tracking without a separate reporting layer bolted on afterwards. Instead of a spreadsheet reconciled at shift end, the KPI updates as the machine publishes. An on-site demonstration shows how connected machinery feeds these dashboards in a live production setting, which is worth seeing before committing to any particular MQTT architecture.
— Andraž
This is a practical route from a working MQTT pilot to an MES that plant managers actually use, without building custom dashboards on top of raw broker topics yourself. Where a DIY stack leaves you assembling visualisation, quality logic and downtime reporting from separate tools, a suitable MES subscribes directly to machine topics and turns them into KPIs, cost analysis and quality alerts your team can act on the same shift.
If your pilot machine is already publishing telemetry, the next step is straightforward: connect that feed to a system built for production KPIs rather than generic charts. See how MES compares to traditional manufacturing tracking and request an on-site demonstration to see your own machine data rendered as live dashboards before deciding how far to scale.


 069 763 552